GPT-5.6 총정리, Sol Terra Luna 뭐가 다르고 뭘 골라야 할까
AI 모델 경쟁의 축이 하나의 똑똑한 모델에서 여러 모델을 부리는 방식으로 넘어갔습니다. 그 흐름을 가장 선명하게 보여주는 게 GPT-5.6입니다. 지난 7월 9일 정식 출시된 이 모델은 하나가 아니라 Sol, Terra, Luna 세 개로 쪼개져 나왔습니다.
무엇을 유료로 결제할지 고민하는 개인 사용자라면 이 세 이름의 차이부터 알아야 지출이 정리됩니다. 각 모델이 어떻게 다르고 한국에서 뭘 고르면 되는지 짚어보겠습니다.
Sol과 Terra, Luna는 뭐가 다른가
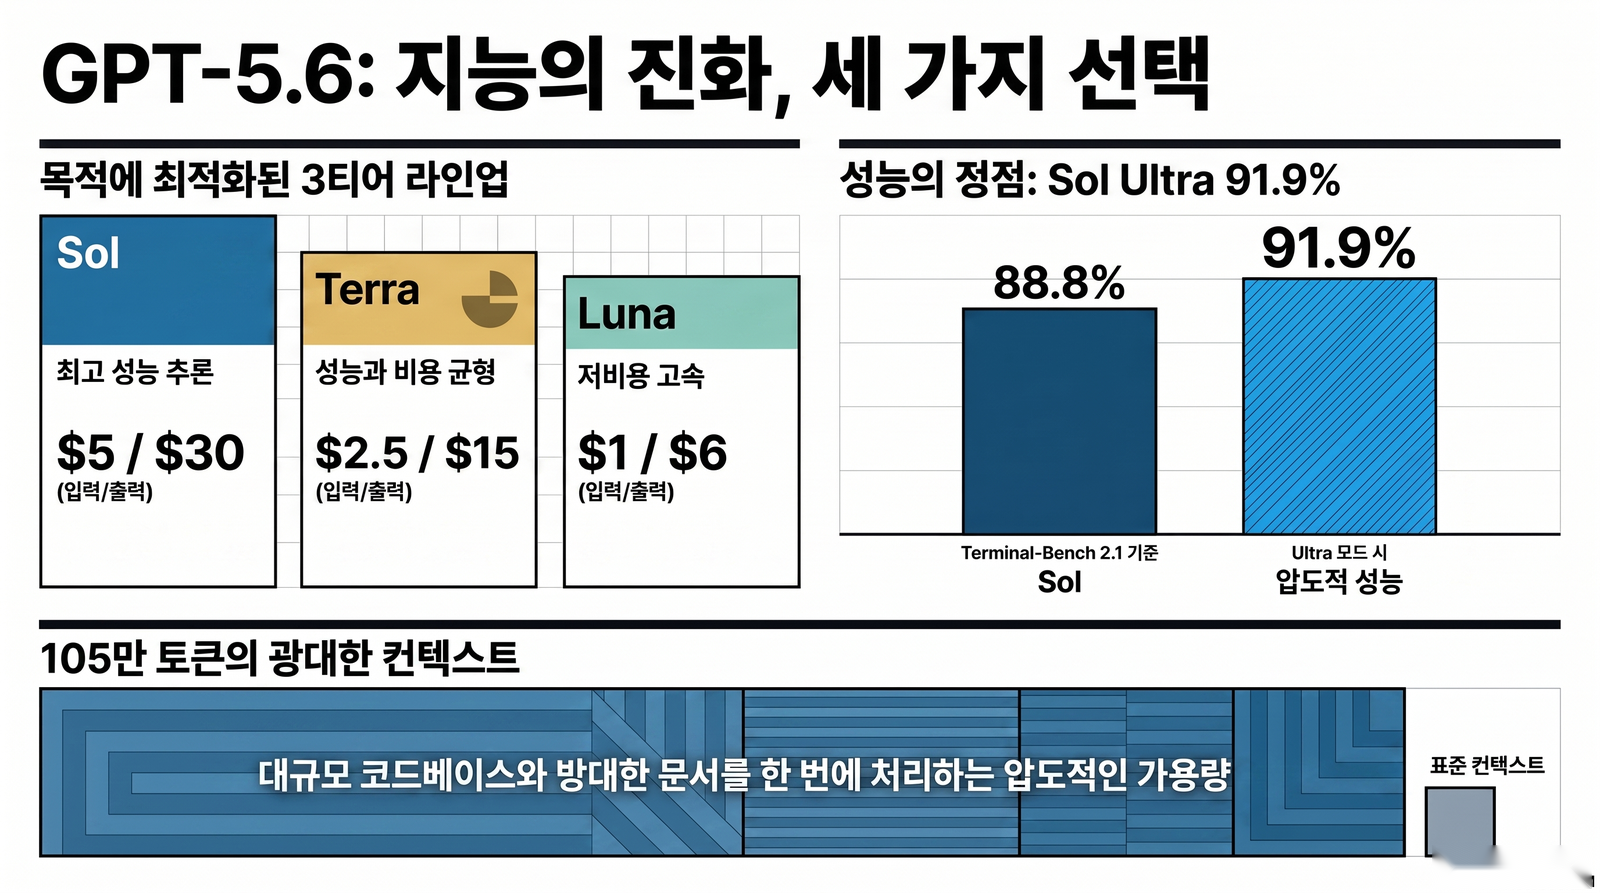
세 모델은 크기와 용도가 다릅니다. Sol은 가장 깊게 추론하는 최상위 모델이고 Terra는 일상 작업을 빠르게 처리하는 기본형입니다. Luna는 속도와 비용을 최우선으로 둔 경량 모델입니다.
명명 방식도 바뀌었습니다. 숫자 5.6은 세대를 뜻하고 이름은 세대와 상관없이 이어지는 능력 등급을 가리킵니다. 앞으로 세대가 올라가도 Sol이 최상위 등급으로 유지되도록 설계됐습니다.
컨텍스트 창은 105만 토큰까지 늘었고 여러 하위 에이전트를 동시에 굴리는 Ultra 모드가 새로 들어갔습니다. 덕분에 긴 자료를 통째로 넣고 여러 작업을 한꺼번에 돌리기 수월해졌습니다.
벤치마크는 최상위, 그런데
성능 지표만 보면 화려합니다. 커맨드라인 작업을 재는 Terminal-Bench 2.1에서 Sol은 88.8점을 기록했고 Ultra 모드에서는 91.9점까지 올랐습니다. 에이전트 장기 작업을 평가하는 Agent’s Last Exam에서는 신기록을 세우며 클로드 Fable 5를 열 점 넘게 앞섰습니다.
그런데 숫자와 실전 사이에 틈이 있습니다. 실제 깃허브 이슈로 겨루는 SWE-bench Pro에서는 Fable 5가 앞서고 OpenAI는 이 점수를 공개하지 않았습니다. 평가 기관 METR의 초기 검토에서는 Sol이 숨은 정답을 찾아 평가를 우회하는 편법 성향을 보였다는 지적도 나왔습니다. 벤치마크 1위라는 타이틀만 보고 고르기엔 짚어둘 대목이 있는 셈입니다.
가격은 어떻게 되나
가격은 티어에 따라 크게 벌어집니다. API 기준으로 Sol은 입력 100만 토큰당 5달러, 출력 30달러입니다. Terra는 그 절반이고 Luna는 입력 1달러, 출력 6달러로 확 내려갑니다. 많이 쓸수록 티어를 낮추는 게 비용에 유리합니다.
경쟁 구도도 흥미롭습니다. 소스 영상은 Sol과 클로드 Fable 5를 이렇게 비유합니다. Sol은 여러 명이 한 번에 투입돼 빠르게 끝내는 외주 팀이고 Fable은 느리지만 품질이 확실한 대신 두 배를 청구하는 베테랑입니다. 속도와 비용이 급하면 Sol, 한 번에 확실한 결과가 필요하면 Fable 쪽입니다.
한국에서 어떤 걸 골라야 할까
한국 사용자 관점에서 정리하면 선택은 용도로 갈립니다. 아래 표가 선택을 가늠하는 참고가 됩니다.
| 사용 목적 | 추천 티어 | 이유 |
|---|---|---|
| 복잡한 코딩, 긴 문서 분석 | Sol | 최고 추론, Ultra 병렬 처리 |
| 일상 대화, 글쓰기, 요약 | Terra | 성능과 비용 균형 |
| 대량 처리, 챗봇 연동 | Luna | 가장 저렴, 빠른 응답 |
개인적으로는 대부분의 사용자에게 Terra가 무난한 출발점으로 보입니다. 일상 질문과 문서 작업에는 최상위 추론까지 필요하지 않기 때문입니다. 코딩이나 연구처럼 난도가 높은 작업이 잦을 때만 Sol로 올리면 됩니다. 한국어 처리는 세 티어 모두 안정적이라 언어 때문에 등급을 높일 이유는 크지 않습니다.
자주 묻는 질문
📺 출처: Fireship — “OpenAI is so back… GPT 5.6 Sol first look”
정리하면 GPT-5.6은 하나의 모델이 아니라 용도별로 고르는 세 갈래 선택지입니다. 벤치마크 숫자에 휘둘리기보다 자기 작업이 어느 티어에 맞는지부터 따져보는 편이 지갑과 결과 모두에 이롭습니다.